Indexierungsprobleme beheben: So kommen Ihre Seiten in den Index
Wenn Google eine Seite nicht indexiert, gehen Sie in einer festen Reihenfolge vor. Zuerst prüfen Sie in der Search Console, ob die Seite überhaupt indexiert werden darf (robots.txt, noindex, Statuscode, Canonical). Danach klären Sie, ob Google sie findet und crawlen kann (interne Links, Sitemap, Server, Rendering). Zuletzt geht es um die Frage, ob der Inhalt genug eigenen Wert hat. Die meisten Indexierungsprobleme lassen sich so in wenigen Stunden eingrenzen. Bis Google die Korrektur übernimmt, vergehen dann meist einige Tage bis zwei Wochen.
Kurz gesagt
- Eine nicht indexierte Seite erscheint nicht in der Google-Suche. Bevor Sie von einem Fehler ausgehen, warten Sie nach dem Einreichen mindestens eine Woche.
- Gefunden – zurzeit nicht indexiert heißt: Google kennt die URL, hat sie aber noch nicht gecrawlt. Gecrawlt – zurzeit nicht indexiert heißt: Google hat die Seite gesehen und sich gegen die Aufnahme entschieden.
- Technische Blockaden prüfen Sie zuerst, weil sie eindeutig und schnell behoben sind: robots.txt, noindex, falsches Canonical, Weiterleitungen, 404- und Serverfehler.
- Danach kommen interne Verlinkung, Sitemap-Hygiene und Inhaltsqualität. Dünne und doppelte Seiten werden zusammengelegt oder bewusst ausgeschlossen.
- Kümmern Sie sich zuerst um die Seiten, die Umsatz bringen. Eine Indexierungsquote von 100 Prozent ist kein sinnvolles Ziel.
Inhaltsverzeichnis
- Was „nicht indexiert“ bedeutet und wann es wirklich ein Problem ist
- Diagnose in der Search Console: Schritt für Schritt
- „Gefunden“ oder „Gecrawlt“: zwei Meldungen, zwei Ursachen
- Technische Blockaden finden und lösen
- Crawling, interne Verlinkung, Rendering und Sitemap
- Wenn Google den Inhalt nicht aufnehmen will
- Prüfen, ob die Korrektur greift
- Unsere Sicht: Priorisierung statt Fehlerliste
- Indexierung prüfen lassen
- Häufige Fragen
- Quellen
Was „nicht indexiert“ bedeutet und wann es wirklich ein Problem ist
Google arbeitet in zwei Schritten. Beim Crawling ruft der Googlebot eine URL ab. Bei der Indexierung entscheidet Google, ob die Seite in den Suchindex aufgenommen wird. Nur indexierte Seiten können ranken. Ist eine Seite nicht im Google-Index, erscheint sie auch nicht in den Suchergebnissen. Nach einer Veröffentlichung kann die Aufnahme ein oder zwei Tage, aber auch einige Wochen dauern. Google rät, nach dem Einreichen einer Sitemap oder eines Indexierungsantrags mindestens eine Woche zu warten.
Wichtig für Ihre Erwartungen: Google kann weder vorhersagen noch garantieren, wann oder ob URLs gecrawlt und indexiert werden. Auch eine Sitemap garantiert keine Indexierung und verbessert kein Ranking. Sie hilft Google nur, Ihre Website besser kennenzulernen.
Nicht jede nicht indexierte URL ist ein Fehler. Laut dem Bericht zur Seitenindexierung indexiert Google nicht alle URLs im Web. Viele Ausschlüsse sind gewollt: Parameter-Varianten, Duplikate mit korrektem Canonical, Weiterleitungen nach einem Relaunch, bewusst gesperrte Bereiche. Ein echtes Problem haben Sie, wenn eine der folgenden Seiten fehlt:
- Leistungs- und Produktseiten, über die Anfragen oder Verkäufe entstehen
- Standort- und Branchenseiten, für die Sie gefunden werden wollen
- neue Fachartikel, die auch nach mehreren Wochen nicht auftauchen
- ganze Seitentypen, etwa alle Blogartikel oder alle Kategorien
Im letzten Fall steckt fast immer eine gemeinsame Ursache dahinter, etwa ein Template, eine Plugin-Einstellung oder die Art, wie Ihr Framework rendert.
Diagnose in der Search Console: Schritt für Schritt
Die Google Search Console ist Ihr wichtigstes Werkzeug. So gehen Sie vor:
- Bericht „Seitenindexierung“ öffnen. In der Tabelle „Warum Seiten nicht indexiert werden“ sehen Sie die Gründe mit der Zahl der betroffenen URLs. Ein Klick auf eine Zeile öffnet eine Detailseite mit den betroffenen URLs und dem bisherigen Verlauf.
- Nach Seitentyp sortieren. Exportieren Sie die URLs und ordnen Sie sie nach Verzeichnis oder Template. Betreffen 300 Meldungen ausschließlich Tag-Seiten, haben Sie ein anderes Problem als bei 12 fehlenden Leistungsseiten.
- Wichtige URLs einzeln prüfen. Geben Sie die URL oben in die URL-Prüfung ein. Das Tool zeigt, ob das Crawling laut robots.txt erlaubt ist, ob der Seitenabruf funktioniert hat, ob noindex die Indexierung blockiert, welche kanonische URL Google gewählt hat und wann zuletzt gecrawlt wurde.
- Live-Test ausführen. Der Live-Test zeigt den aktuellen Zustand der Seite, nicht den Stand des letzten Crawls. So sehen Sie, ob eine Korrektur schon online ist.
- Sitemap kontrollieren. Im Sitemaps-Bericht sehen Sie, ob Ihre Sitemap gelesen wurde und wie viele URLs darin erkannt wurden.
Eine Sitemap reichen Sie ein, indem Sie die Datei auf Ihrer Website veröffentlichen, für den Googlebot erreichbar machen, ihre URL im Sitemaps-Bericht eintragen und auf „Senden“ klicken. Laut der Search-Console-Hilfe zum Sitemaps-Bericht ruft Google die Datei normalerweise sofort ab, das Crawlen der enthaltenen URLs dauert aber länger. Zusätzlich können Sie die Sitemap in der robots.txt mit der Zeile Sitemap: https://example.com/my_sitemap.xml angeben. Auch das ist laut Google nur ein Hinweis und keine Garantie.
„Gefunden“ oder „Gecrawlt“: zwei Meldungen, zwei Ursachen
Diese beiden Status sorgen für die meisten Fragen, weil sie ähnlich klingen. Sie stehen aber an verschiedenen Stellen im Prozess.
| Gefunden – zurzeit nicht indexiert | Gecrawlt – zurzeit nicht indexiert | |
|---|---|---|
| Was passiert ist | Google kennt die URL, etwa aus der Sitemap oder über einen Link, hat sie aber noch nicht abgerufen | Google hat die Seite abgerufen und vorerst nicht in den Index aufgenommen |
| Wo es hakt | Crawling: Priorität, Serverkapazität, Linkstruktur | Bewertung: Inhalt, Duplikate, Mehrwert |
| Typische Auslöser | viele neue URLs auf einmal, schwache interne Verlinkung, langsamer oder überlasteter Server, Parameter-URLs | dünne Inhalte, starke Überschneidung mit anderen Seiten, Seiten ohne eigenen Zweck |
| Erster Schritt | interne Links von starken Seiten setzen, Server prüfen, Sitemap bereinigen | Inhalt ausbauen oder Seiten zusammenlegen, Unwichtiges auf noindex setzen |
Bei Gefunden – zurzeit nicht indexiert ist die URL bekannt, aber noch nicht besucht worden. Google empfiehlt im Bericht zur Seitenindexierung unter anderem, dafür zu sorgen, dass der Server nicht offline, überlastet oder falsch konfiguriert ist. Außerdem sollten Parameterlisten in URLs sparsam und kurz bleiben. Nach dem Bekanntwerden einer URL kann es bis zu ein paar Wochen dauern, bis Google die Website oder Teile davon crawlt. Häufen sich diese Meldungen bei einem großen Teil der Website, schickt Ihre Struktur Google meist zu viele unwichtige URLs und zu wenige klare Signale für die wichtigen.
Zu Gecrawlt – zurzeit nicht indexiert schreibt Google, die Meldung sei für viele Websites üblich und weise nicht unbedingt auf ein Problem hin. Seit einer Überarbeitung der Hilfe betont Google das noch deutlicher, wie Dr. Web zusammenfasst. Sehen Sie die Meldung bei wichtigen Seiten, prüfen Sie diese einzeln auf Sperren oder eine abweichende kanonische URL. Trifft es einen ganzen Seitentyp, ist das ein Hinweis auf die Qualität dieser Seiten.
Technische Blockaden finden und lösen
Technische Ursachen gehören an den Anfang, weil sie eindeutig sind. Eine falsche Zeile in der robots.txt oder ein vergessenes noindex nach dem Relaunch kann ganze Verzeichnisse aus dem Index halten, und die Korrektur ist oft in Minuten erledigt.
| Ursache | Woran Sie es erkennen | Lösung |
|---|---|---|
| Sperre in der robots.txt | URL-Prüfung: „Crawling erlaubt? Nein“ | Disallow-Regel für wichtige Pfade entfernen, CSS, JavaScript und Bilder nicht sperren |
| noindex | „Indexierung zulässig? Nein“, Meta-Robots-Tag oder X-Robots-Tag im Header | noindex auf Seiten entfernen, die ranken sollen, Template- und Plugin-Einstellungen prüfen |
| Canonical auf eine andere URL | „Von Google ausgewählte kanonische URL“ weicht ab | Canonical auf die eigene URL setzen oder Duplikate zusammenlegen |
| Weiterleitung | Status „Seite mit Weiterleitung“ | Ketten und Schleifen auflösen, intern direkt auf das Ziel verlinken, 301 bei dauerhaften Umzügen |
| 404 und Soft 404 | Seitenabruf fehlgeschlagen oder leere Seite mit Status 200 | Seite wiederherstellen, per 301 umleiten oder bewusst entfernen |
| Serverfehler (5xx) | Seitenabruf fehlgeschlagen, Spitzen in der Crawling-Statistik | Hosting, Caching und Zeitüberschreitungen mit dem Hoster klären |
Drei Punkte werden in der Praxis besonders oft verwechselt:
robots.txt ist kein Mittel gegen die Indexierung. Google empfiehlt, mit der robots.txt das Crawling von Duplikaten und unwichtigen Ressourcen zu steuern. Um eine Indexierung zu verhindern, gehören noindex oder ein Login dazu. Wichtige Ressourcen wie Bilder und CSS dürfen nicht gesperrt sein. Liegt auf einer gesperrten Seite außerdem noindex, kann Google dieses Tag gar nicht lesen. Wie Sie die Datei sauber aufsetzen, erklären wir in unserem Beitrag zu robots.txt und Crawling-Steuerung.
Ein Canonical ist eine Empfehlung, keine Anweisung. Google wählt unter Umständen eine andere kanonische Seite, auch wenn Sie selbst eine festlegen, etwa wegen der Inhaltsqualität oder widersprüchlicher technischer Signale. Canonical, interne Links, Sitemap und hreflang sollten deshalb auf dieselbe URL zeigen. Die Grundlagen dazu finden Sie in unserem Artikel über Canonical Tags richtig implementieren. Bei Sprachversionen hilft unser Leitfaden zu SEO für mehrsprachige Websites.
Weiterleitungen nach Umzügen sind dauerhaft. Bei einer Umstrukturierung oder der Umstellung auf HTTPS empfiehlt Google 301-Weiterleitungen. Dieselbe Hilfeseite nennt auch manuelle Maßnahmen und Sicherheitsprobleme als Gründe, warum Seiten nicht in der Suche erscheinen. Beides sehen Sie im gleichnamigen Bereich der Search Console.
Crawling, interne Verlinkung, Rendering und Sitemap
Ist technisch nichts gesperrt und die Seite trotzdem nur „gefunden“, braucht Google stärkere Signale, dass sie wichtig ist.
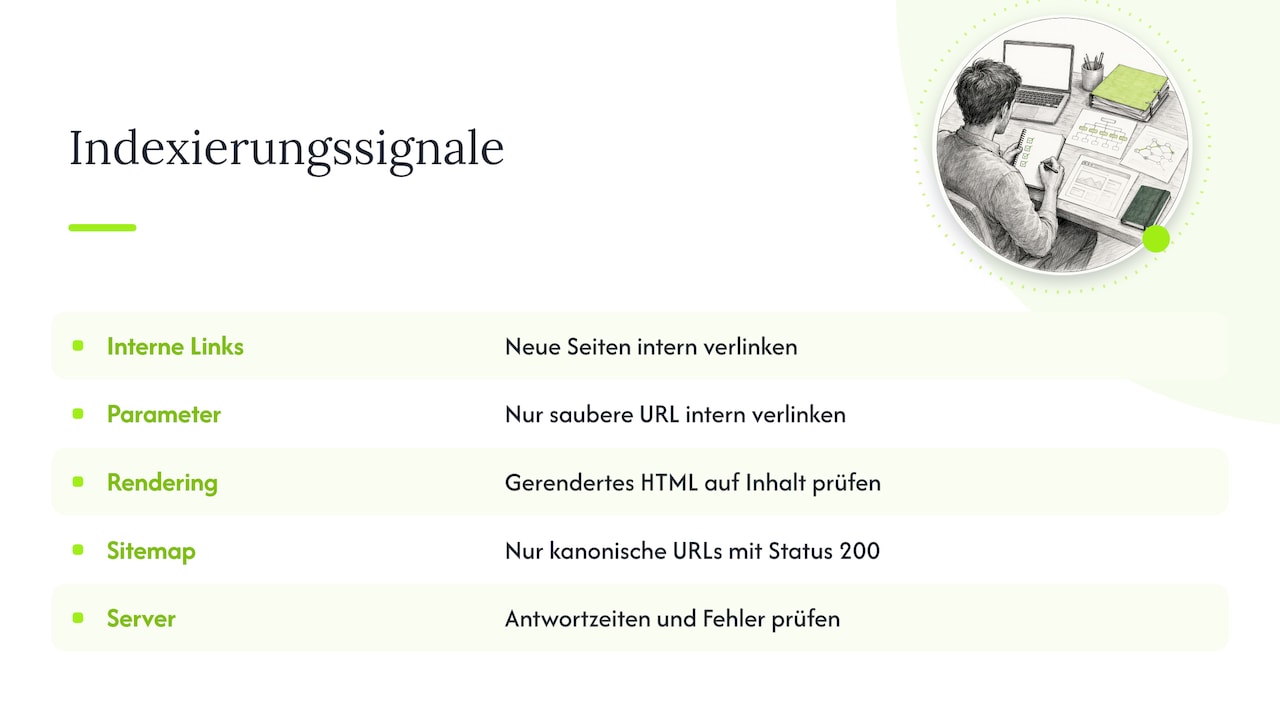
Interne Verlinkung. Eine Seite, die nur in der Sitemap steht und von keiner anderen Seite verlinkt wird, wirkt auf Google wie eine Nebensache. Verlinken Sie neue und wichtige Seiten aus dem Hauptmenü, von thematisch passenden Leistungsseiten und aus aktuellen Artikeln. Wichtige Seiten sollten mit wenigen Klicks von der Startseite erreichbar sein. Kaputte interne Links und Links auf weitergeleitete URLs prüfen Sie regelmäßig mit einem Crawler.
Parameter und Filter. Shops und Portale erzeugen über Filter, Sortierungen und Session-Parameter schnell tausende Varianten derselben Seite. Google zeigt im Bericht zur Seitenindexierung selbst das Beispiel zweier Parameter-URLs mit identischem Inhalt. Verlinken Sie intern nur die saubere Version. Filterseiten öffnen Sie nur dort für die Suche, wo es echte Nachfrage gibt.
Rendering. Bei Websites mit React, Vue oder Next.js muss Google den Inhalt oft erst per JavaScript erzeugen. Fehlen im gerenderten HTML Text, Links oder Metadaten, wirkt die Seite auf Google leer oder dünn. In der URL-Prüfung sehen Sie mit „Gecrawlte Seite ansehen“, was der Googlebot tatsächlich erhalten hat. Wie sich serverseitiges Rendering und statische Generierung auf die Indexierung auswirken, beschreiben wir in unseren Beiträgen zu JavaScript SEO und SEO für Next.js.
Sitemap-Hygiene. In die Sitemap gehören nur kanonische, indexierbare URLs mit Status 200. Weiterleitungen, noindex-Seiten und Duplikate darin senden widersprüchliche Signale. Sinnvoll ist ein lastmod-Datum, das sich nur bei echten inhaltlichen Änderungen ändert.
Server. Langsame Antworten und Zeitüberschreitungen bremsen das Crawling. Der Bericht „Crawling-Statistik“ in der Search Console zeigt Antwortzeiten und Fehler. Bleiben die Probleme bestehen, empfiehlt Google, mit dem Hoster über mehr Kapazität zu sprechen.
Wenn Google den Inhalt nicht aufnehmen will
Beim Status „Gecrawlt – zurzeit nicht indexiert“ hat Google Ihre Seite gesehen und sich vorerst dagegen entschieden. Das betrifft häufig diese Fälle:
- Dünne Seiten: Tag-Archive, leere Kategorien, Standortseiten, die sich nur im Ortsnamen unterscheiden, Produktseiten mit reinem Herstellertext.
- Überschneidungen: mehrere Artikel zum selben Thema, Druckversionen, nahezu gleiche Landingpages für Kampagnen.
- Fehlende eigene Substanz: Texte, die nur wiederholen, was schon hundertfach im Netz steht.
So gehen Sie damit um:
- Zusammenlegen statt vervielfältigen. Führen Sie ähnliche Seiten zu einer starken Seite zusammen und leiten Sie die alten URLs per 301 weiter.
- Ausbauen, was zählt. Ergänzen Sie Leistungs- und Produktseiten um konkrete Informationen: Ablauf, Preise, Einsatzbeispiele, Fragen aus dem Vertrieb.
- Bewusst ausschließen. Seiten ohne Suchnutzen, etwa interne Suchergebnisse oder Filterkombinationen, setzen Sie auf noindex und nehmen sie aus der Sitemap.
- Intern stärken. Verlinken Sie die überarbeitete Seite von Ihren stärksten Seiten aus.
Duplikate an sich sind kein Regelverstoß. Laut Google verstoßen Content-Duplikate im Allgemeinen nicht gegen die Spamrichtlinien. Sie kosten aber Crawling-Ressourcen und verwässern die Signale, welche Version ranken soll. Wie Sie Inhalte entlang der Suchintention planen, beschreibt unsere Seite zu Content & SEO.
Prüfen, ob die Korrektur greift
Nach der Korrektur geben Sie Google ein Signal und messen nach.
- Live-Test in der URL-Prüfung. Er bestätigt, dass die Seite jetzt abrufbar und indexierbar ist. Ein bestandener Test garantiert aber nicht, dass die Seite in den Suchergebnissen erscheint, weil das Tool zum Beispiel manuelle Maßnahmen nicht prüft.
- Indexierung beantragen. Für einzelne wichtige URLs nutzen Sie „Indexierung beantragen“. Bei vielen URLs ist eine aktuelle Sitemap der bessere Weg.
- Korrektur validieren. Im Bericht zur Seitenindexierung klicken Sie beim jeweiligen Grund auf „Korrektur validieren“. Die Validierung dauert normalerweise etwa zwei Wochen, manchmal deutlich länger. Search Console prüft zuerst eine Stichprobe. Tritt das Problem dort noch auf, endet die Validierung.
- Geduld bei Duplikaten. Nach der Behebung von Inhaltsproblemen kann Google Seiten bis zu zwei Wochen in einem Duplikat-Cluster halten.
- Trend beobachten. Entscheidend ist die Entwicklung der indexierten Seiten Ihres wichtigen Seitentyps über mehrere Wochen, nicht eine einzelne Tagesmeldung.
Eine strukturierte Vorlage für die gesamte technische Prüfung finden Sie in unserer Checkliste für den technischen SEO-Audit.
Unsere Sicht: Priorisierung statt Fehlerliste
In der Search Console sehen viele Unternehmen eine lange Liste mit Meldungen und arbeiten sie von oben nach unten ab. Das kostet Zeit und bringt oft wenig, weil die Liste nicht nach geschäftlicher Bedeutung sortiert ist.
Wir fangen deshalb bei der Frage an, welche Seiten Anfragen und Umsatz bringen sollen, und prüfen zuerst deren Indexierungsstatus. Danach ordnen wir jede Ursache nach Wirkung und Aufwand. Ein falsches noindex auf zwanzig Leistungsseiten hat Vorrang vor fünfhundert Parameter-URLs, die ohnehin nicht in den Index gehören.
Gerade bei B2B-Technologiefirmen liegt die Ursache oft im Code: im Rendering, in Metadaten, die erst im Browser entstehen, oder in Canonicals, die ein Framework automatisch setzt. Weil wir technisches SEO mit Erfahrung in React und Next.js verbinden, finden wir solche Ursachen direkt im Quellcode und setzen die Lösung selbst um oder geben sie präzise an Ihr Entwicklerteam weiter.
Unsere datenbasierten, AI-gestützten Workflows helfen uns, tausende URLs nach Mustern zu gruppieren. So arbeiten wir an den Ursachen statt an einzelnen Symptomen. Sie haben dabei einen festen Ansprechpartner und messbare KPIs, etwa die Zahl der indexierten Seiten pro wichtigem Seitentyp.
Aliniyaz
Indexierung prüfen lassen
Wenn Sie Ihre Indexierungsprobleme lieber gemeinsam mit uns lösen möchten, ist die SEO Foundation ein sinnvoller Einstieg. Das ist eine einmalige Leistung ab 999 €, die den technischen Zustand Ihrer Website erfasst und die Maßnahmen nach Priorität ordnet. Für die laufende Umsetzung gibt es die monatliche Betreuung, beginnend mit SEO Essentials ab 999 € pro Monat. Alle Pakete und Preise finden Sie auf unserer Preisübersicht.
Wie wir dabei vorgehen, von der Analyse über die Priorisierung bis zur Messung, zeigt unser SEO-Prozess. Einzelheiten zu Crawling, Indexierung und Performance finden Sie auf unserer Seite zu Technical SEO.
Häufige Fragen
Wie lange dauert die Indexierung bei Google?
Nach Angaben von Google dauert die Indexierung ein oder zwei Tage bis einige Wochen. Nach dem Einreichen einer Sitemap oder einem Indexierungsantrag sollten Sie mindestens eine Woche warten, bevor Sie von einem Problem ausgehen. Eine Garantie für einen Zeitpunkt gibt Google nicht.
Warum finde ich meine Website bei Google nicht?
Geben Sie in der Google-Suche site:ihredomain.de ein, um grob zu sehen, ob überhaupt Seiten indexiert sind. Erscheint nichts, prüfen Sie in der Search Console, ob robots.txt, noindex, Serverfehler oder eine manuelle Maßnahme die Indexierung verhindern. Ist die Seite indexiert, aber schwer zu finden, haben Sie kein Indexierungsproblem, sondern ein Ranking-Thema.
Hilft es, „Indexierung beantragen“ mehrmals zu klicken?
Nein. Ein wiederholter Antrag für dieselbe URL beschleunigt nichts. Beheben Sie zuerst die Ursache, bestätigen Sie die Korrektur mit dem Live-Test und stellen Sie den Antrag dann einmal. Für viele URLs ist eine bereinigte Sitemap der richtige Weg.
Müssen alle Seiten meiner Website indexiert sein?
Nein. Google indexiert nicht alle URLs, und viele Ausschlüsse sind gewollt, zum Beispiel Duplikate, Weiterleitungen oder Filterseiten. Wichtig ist, dass Ihre geschäftlich relevanten Seiten im Index sind. Die Gesamtquote ist zweitrangig.
Quellen
- Google Search Console-Hilfe: Warum wird meine Seite nicht in der Google Suche angezeigt?
- Google Search Central: FAQ Crawling und Indexierung
- Google Search Console-Hilfe: Bericht zur Seitenindexierung
- Google Search Console-Hilfe: Einzelne Seite prüfen und Fehler beheben
- Google Search Console-Hilfe: Sitemaps-Bericht
- Google Search Central: Sitemap erstellen und einreichen
- Google Search Central: Technical SEO, Einstieg
- Google Search Central: Probleme mit der Kanonisierung beheben
- Google Search Console-Hilfe: Details zur Validierung
- Dr. Web: Nicht indexierte Seiten sind in der Search Console oft normal
- Search Engine Land: Canonicalization fixes can take up to two weeks
Empfehlungen
Fragen zu Ihrer eigenen Website?
Besprechen wir unverbindlich, wo Ihre größten SEO-Chancen liegen.