Robots.txt für SEO: So steuern Sie Crawling richtig
Robots.txt steuert, welche Crawler Ihre Seiten abrufen dürfen, sie verhindert aber nicht zuverlässig die Indexierung einzelner URLs. Diese Trennung bestätigt auch Google Search Central ausdrücklich. Wer eine Seite wirklich aus dem Index entfernen will, braucht noindex oder den X-Robots-Tag. Prüfen Sie deshalb zuerst, ob wichtige Ressourcen wie CSS, JavaScript oder Bilder versehentlich gesperrt sind.
Kurz gesagt:
- Die Datei ist öffentlich einsehbar, böswillige Bots können Regeln ignorieren und sensible Verzeichnisse entdecken; schützen Sie vertrauliche Inhalte deshalb mit Passwort oder serverseitiger Anmeldung.
- Eine gesperrte Seite mit noindex bleibt oft trotzdem indexiert, weil der Crawler das Kennzeichen nicht abrufen kann; entfernen Sie den Konflikt gezielt.
- Vor jeder Änderung sollten Sie eine Sicherung anlegen, die Regel in einer Testumgebung prüfen und danach Serverprotokolle sowie Abrufstatistiken in der Google Search Console beobachten.
- Bei Shops können gesperrte Filterpfade auch Varianten mit eigenständigem Suchvolumen treffen; messen Sie deren Nachfrage, bevor Sie sie sperren, kanonisieren oder anders steuern.
- Ein eigener Regelblock kann GPTBot aussperren, doch ein pauschales Verbot für KI-Crawler kann zugleich die Sichtbarkeit in generativen Suchangeboten mindern.
Inhaltsverzeichnis
- Was ist eine robots.txt-Datei? Zweck, Lage und RFC-Hintergrund
- Aufbau und Syntax: User-agent, Disallow, Allow, Sitemap und Platzhalter
- Häufige Fehler und unbeabsichtigte Folgen in der Praxis
- Best Practices: Schlanke Regeln und Crawl-Budget-Steuerung
- Testen und überwachen: Tools, Logs und Validierung
- Robots.txt und KI-Crawler: Umgang mit GPTBot, Google-Extended & Co.
- Praxis: Wann professionelle Technical-SEO-Hilfe sinnvoll wird
- Persönliche Perspektive: Priorisierung statt endloser To-do-Listen
- Wie wir bei robots.txt und Indexierbarkeit konkret unterstützen
- FAQ
- Quellen
Was ist eine robots.txt-Datei? Zweck, Lage und RFC-Hintergrund
Die robots.txt liegt immer im Stammverzeichnis einer Domain, also unter domain.tld/robots.txt, und ist eine einfache Textdatei. Sie gehört zum Robots Exclusion Protocol, kurz REP, das inzwischen offiziell als RFC 9309 standardisiert ist. Vor dieser Formalisierung folgten Suchmaschinen und Webmaster eher einer informellen Konvention, die sich über Jahre durchgesetzt hatte.
Der eigentliche Zweck ist schlicht: Crawler sollen wissen, welche Bereiche einer Website sie abrufen dürfen und welche nicht. Das entlastet Server bei großen Websites mit Millionen URLs und lenkt das sogenannte Crawl-Budget auf die Seiten, die wirklich zählen. Google selbst beschreibt robots.txt als Werkzeug zur Vermeidung von Serverüberlastung, nicht als Zugriffsschutz.
Genau hier liegt ein Missverständnis, das viele Website-Betreiber teuer zu stehen kommt:
- Robots.txt ist öffentlich einsehbar und für jeden abrufbar, auch für Menschen.
- Sie blockiert kein unerwünschtes Verhalten böswilliger Bots, die sich schlicht nicht an die Regeln halten.
- Sie schützt keine sensiblen Daten, denn die Datei verrät oft sogar, wo sich interessante Verzeichnisse befinden.
- Verlinkte, aber per robots.txt gesperrte URLs können trotzdem in Suchergebnissen auftauchen, nur ohne Snippet.
Für echten Zugriffsschutz braucht es Passwortschutz oder serverseitige Authentifizierung. Robots.txt bleibt ein Steuerungsinstrument für Crawling, kein Sicherheitsmechanismus und auch kein zuverlässiger Indexierungsschalter.
Aufbau und Syntax: User-agent, Disallow, Allow, Sitemap und Platzhalter
Die Syntax der robots.txt ist bewusst einfach gehalten, folgt aber festen Regeln, die Robotstxt mit zahlreichen Praxisbeispielen dokumentiert. Jeder Regelblock beginnt mit einer User-agent-Zeile, gefolgt von einer oder mehreren Disallow- oder Allow-Anweisungen.
- User-agent: legt fest, für welchen Crawler der folgende Block gilt, etwa Googlebot oder ein Sternchen für alle Bots.
- Disallow: sperrt einen Pfad für das Crawling, zum Beispiel Disallow: /admin/.
- Allow: erlaubt gezielt einen Unterpfad, auch innerhalb eines gesperrten Verzeichnisses.
- Sitemap: verweist auf die XML-Sitemap und hilft Crawlern, relevante URLs schneller zu finden.
- Platzhalter: Das Sternchen steht für eine beliebige Zeichenfolge, das Dollarzeichen markiert das Ende einer URL.
Mehrere User-agent-Blöcke lassen sich problemlos kombinieren, wenn unterschiedliche Bots unterschiedlich behandelt werden sollen. Ein Googlebot-Block kann großzügiger sein als die Regel für alle übrigen Crawler.
| Regel | Bedeutung |
|---|---|
Disallow: /images/ |
Sperrt das gesamte Verzeichnis /images/ für Crawling |
Allow: /images/public/ |
Erlaubt gezielt einen Unterordner innerhalb eines gesperrten Verzeichnisses |
Disallow: /*.pdf$ |
Sperrt alle Dateien, die auf .pdf enden |
Sitemap: https://domain.tld/sitemap.xml |
Verweist Crawler auf die Sitemap-Datei |
Eine typische Kombination aus Sperrung und gezielter Freigabe sieht in der Praxis so aus: User-agent: * gefolgt von Disallow: /images/ und direkt darunter Allow: /images/public/. Damit bleibt ein öffentlicher Unterordner crawlbar, während der restliche Bildbestand draußen bleibt.
Häufige Fehler und unbeabsichtigte Folgen in der Praxis
Fehlkonfigurationen in der robots.txt gehören zu den teuersten technischen SEO-Fehlern, weil sie oft lange unentdeckt bleiben.
- Blockierte Ressourcen: Wer JavaScript-, CSS- oder Font-Dateien sperrt, verhindert, dass Google die Seite korrekt rendert, was Google Search Central gerade für JavaScript-Frameworks wie React oder Next.js ausdrücklich warnt.
- noindex-Konflikt: Eine Seite, die gleichzeitig per robots.txt gesperrt und mit einem noindex-Tag versehen ist, bleibt oft trotzdem im Index, weil der Crawler das noindex-Tag nie zu Gesicht bekommt.
- Overblocking: Ein versehentliches Disallow: / im Stammverzeichnis sperrt die gesamte Website und zählt zu den folgenreichsten Tippfehlern überhaupt.
- Veraltete Muster: Alte Regeln aus früheren Relaunches bleiben oft stehen und blockieren Bereiche, die längst wieder relevant sind.
Jeder dieser Fehler lässt sich mit einer regelmäßigen Kontrolle der Datei und einem Blick in die Search Console vermeiden.
Best Practices: Schlanke Regeln und Crawl-Budget-Steuerung
Weniger ist bei robots.txt fast immer mehr. Eine überladene Datei mit Dutzenden Spezialregeln wird schwer wartbar und erhöht das Risiko von Widersprüchen zwischen einzelnen Blöcken.
- Halten Sie die Struktur so schlank wie möglich, mit klaren, eindeutigen Pfaden statt verschachtelter Platzhalter.
- Nutzen Sie robots.txt gezielt für dynamische Parameter, facettierte Navigationen und interne Suchergebnisseiten, die sonst unnötig Crawl-Budget binden.
- Kombinieren Sie die Datei immer mit noindex oder dem X-Robots-Tag, wenn tatsächlich eine Deindexierung gewünscht ist.
- Verweisen Sie in der robots.txt auf die aktuelle Sitemap, damit Crawler neue Inhalte schneller finden.
- Prüfen Sie interne Verlinkung und Serverantwortzeiten parallel, denn robots.txt wirkt nie isoliert.
Gerade bei großen Shops mit facettierten Filtern entstehen schnell Hunderte von URL-Varianten, die laut Google Search Central das Crawl-Budget unnötig belasten. Hier lohnt sich eine klare Entscheidung: blockieren, kanonisieren oder per Parameter-Handling steuern.
Profi-Tipp: Dokumentieren Sie jede Änderung an der robots.txt mit Datum und Grund, damit spätere Rankingschwankungen sich schnell zurückverfolgen lassen.
Testen und überwachen: Tools, Logs und Validierung
Eine robots.txt ohne Monitoring ist ein Risiko, das sich leicht vermeiden lässt. Google stellt dafür konkrete Werkzeuge bereit, die regelmäßig genutzt werden sollten.
- Robots.txt Tester nutzen: Die Google Search Console bietet eine Testfunktion, mit der sich einzelne URLs gegen die aktuellen Regeln prüfen lassen, bevor sie live gehen.
- Server-Logs auswerten: Ein Blick auf 403- und 404-Fehler sowie auf das tatsächliche Bot-Verhalten zeigt, ob Crawler an unerwarteten Stellen abgewiesen werden.
- Crawl-Statistiken beobachten: Die Crawling-Statistiken in der Search Console zeigen, ob sich das Crawl-Volumen nach einer Änderung sinnvoll verschiebt.
- Deployment-Checkliste abarbeiten: Backup der alten Datei anlegen, Änderung zunächst in einer Staging-Umgebung testen, danach ein Re-Crawling anstoßen und die Entwicklung in den folgenden Tagen beobachten.
Diese vier Schritte lassen sich in jeden Release-Prozess einbauen und verhindern, dass eine kleine Änderung tagelang unentdeckt die Sichtbarkeit beschädigt.
Robots.txt und KI-Crawler: Umgang mit GPTBot, Google-Extended & Co.
Die Frage nach KI-Crawlern ist aktuell eine der meistgestellten rund um robots.txt. Für generative KI-Features verlangt Google grundsätzlich, dass Inhalte crawlbar und indexiert sind, spezielle Dateien wie eine separate KI-Steuerdatei sind laut Google Search Central nicht nötig.
- Google-Extended und ähnliche User-Agents lassen sich gezielt über eigene Blöcke in der robots.txt steuern, unabhängig vom klassischen Googlebot.
- Wer einen bestimmten KI-Crawler wie GPTBot aussperren möchte, trägt dafür einen eigenen User-agent-Block mit Disallow: / ein.
- Diese Entscheidung ist eine Abwägung zwischen Sichtbarkeit in generativen Suchfeatures und dem Wunsch, Inhalte nicht für KI-Training freizugeben.
- Ein pauschales Blockieren aller KI-Bots kann gleichzeitig die eigene Präsenz in neueren, generativen Sucherlebnissen schmälern.
Eine typische Regel sieht so aus: User-agent: GPTBot, gefolgt von Disallow: /. Wichtig ist, diese Entscheidung bewusst zu treffen und nicht aus reiner Vorsicht pauschal alle neuen Bot-Namen zu sperren, die in Fachartikeln auftauchen.
Praxis: Wann professionelle Technical-SEO-Hilfe sinnvoll wird
Bei komplexen Migrationen, großen Online-Shops, JavaScript-Websites und facettierten Navigationen reicht eine schnelle robots.txt-Anpassung oft nicht aus. Hier verschränken sich Crawling, Rendering, interne Verlinkung und Serverkonfiguration so stark, dass Einzelmaßnahmen leicht wirkungslos verpuffen.
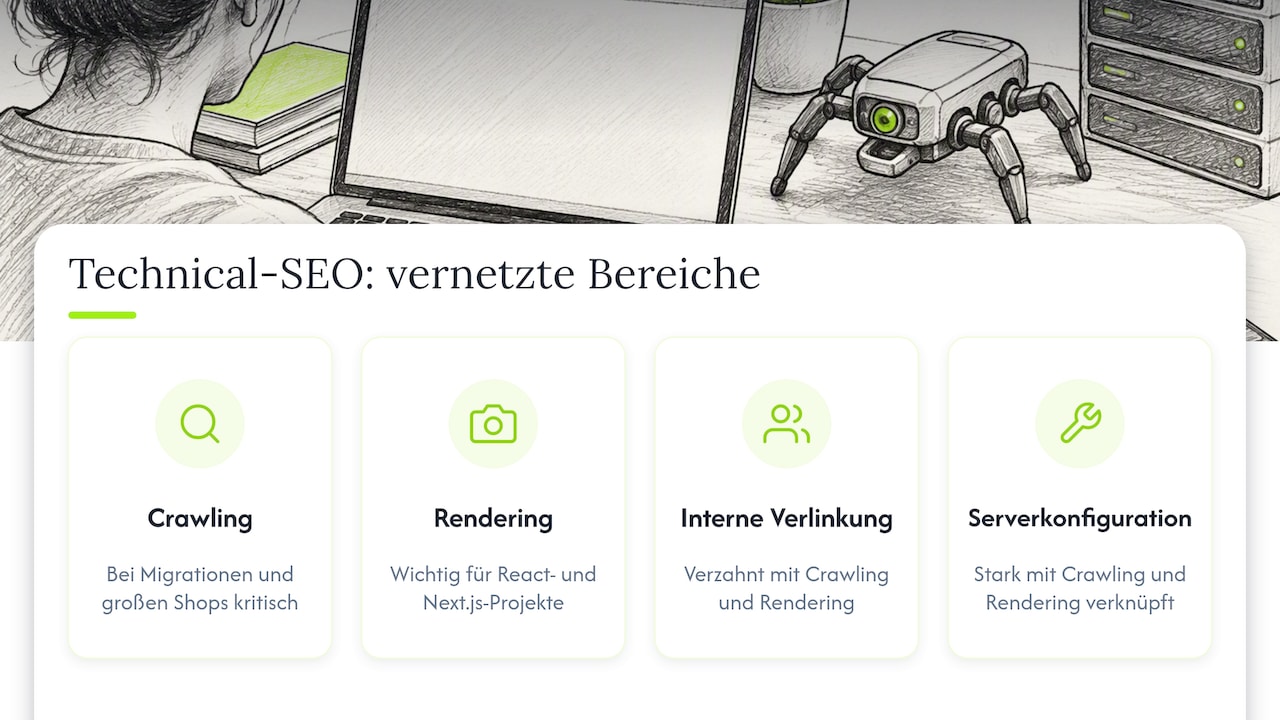
Unsere Leistungen in Technical SEO setzen genau an diesem Punkt an: datenbasierte Priorisierung statt einer langen, generischen To-do-Liste. Für React- und Next.js-Projekte bedeutet das konkret, Rendering-Probleme und Crawling-Blockaden gemeinsam zu betrachten, wie es auch unser Beitrag zu JavaScript SEO beschreibt. Ein Audit liefert dabei messbare KPIs statt vager Empfehlungen, damit Indexierbarkeit tatsächlich nachvollziehbar verbessert wird.
Persönliche Perspektive: Priorisierung statt endloser To-do-Listen
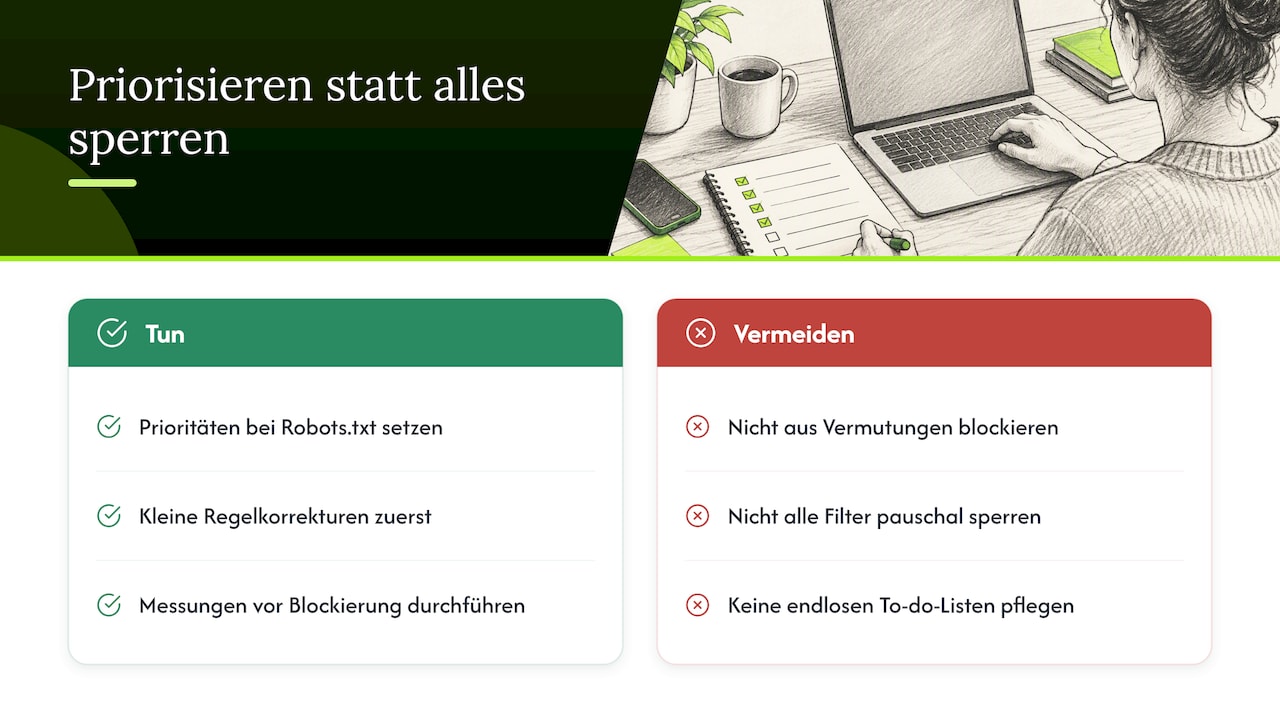
Die meisten robots.txt-Probleme, die ich in Projekten sehe, sind nicht exotisch. Es sind drei oder vier falsch gesetzte Regeln, die seit Jahren unverändert dort liegen. Doch genau diese wenigen Zeilen entscheiden oft mehr über Sichtbarkeit als zwanzig neue Content-Seiten.
Ein Beispiel aus der Praxis: Ein Shop hatte sämtliche Filterparameter gesperrt, darunter aber auch Varianten mit eigenständigem Suchvolumen. Die Korrektur bestand aus zwei Zeilen, nicht aus einem Relaunch. Bevor irgendetwas blockiert wird, sollte deshalb immer eine Messung stehen, nie eine Vermutung.
— Aliniyaz
Wie wir bei robots.txt und Indexierbarkeit konkret unterstützen
Eine fehlerhafte robots.txt lässt sich oft in einem einzelnen Audit aufdecken, doch die Priorisierung der Korrekturen macht den eigentlichen Unterschied. Genau darauf ist unser Angebot zugeschnitten: Wir kombinieren technisches SEO-Wissen mit Erfahrung in modernen Webtechnologien und liefern eine klare, priorisierte Maßnahmenliste statt einer langen Liste unsortierter Punkte.
Unsere Technical SEO Leistungen umfassen Audits, konkrete Fixes und JavaScript-SEO, ergänzt durch laufende Betreuung über SEO Essentials, SEO Growth oder SEO Partner. Jedes Projekt endet mit messbaren KPIs statt mit einer offenen Liste. Wer wissen möchte, wo die eigene robots.txt konkret Sichtbarkeit kostet, findet auf unserer Preise-Seite den passenden Einstieg.
FAQ
Wird robots.txt auch künftig noch genutzt?
Ja, robots.txt gehört weiterhin zum Standardrepertoire der technischen SEO und wird von allen großen Suchmaschinen respektiert. Seit der Formalisierung als RFC 9309 hat die Datei sogar an Verbindlichkeit gewonnen, gerade im Umgang mit neuen KI-Crawlern.
Ist das Setzen einer robots.txt rechtlich zulässig?
Das Anlegen einer robots.txt ist ein etablierter technischer Standard und für jede Website rechtlich unproblematisch. Sie regelt lediglich, welche Crawler welche Bereiche abrufen dürfen, ersetzt aber keinen rechtlichen Zugriffsschutz für sensible Daten.
Wie behebe ich die Meldung „durch robots.txt blockiert“?
Prüfen Sie zunächst mit dem Robots.txt Tester in der Google Search Console, welche konkrete Regel die betroffene URL sperrt. Entfernen oder präzisieren Sie anschließend die Disallow-Zeile und stoßen Sie danach ein erneutes Crawling der betroffenen Seite an.
Blockiert robots.txt automatisch auch die Indexierung?
Nein, robots.txt steuert laut Google Search Central nur das Crawling, nicht zwingend die Indexierung. Eine verlinkte, aber gesperrte URL kann trotzdem ohne Snippet in den Suchergebnissen erscheinen, für echte Deindexierung braucht es noindex oder den X-Robots-Tag.
Sollten Bilder und Videos per robots.txt gesperrt werden?
Das hängt vom Ziel ab: Wer bestimmte Medienverzeichnisse vom Crawling ausschließen möchte, kann das gezielt über eigene Disallow-Regeln für Bildpfade tun. Öffentlich relevante Bilder, die Traffic über die Bildersuche bringen sollen, sollten dagegen crawlbar bleiben.
Quellen
Empfehlungen
Fragen zu Ihrer eigenen Website?
Besprechen wir unverbindlich, wo Ihre größten SEO-Chancen liegen.