Canonical Tags für SEO: Technische Grundlagen und Implementierung
Ein Canonical-Tag mit rel="canonical" weist Suchmaschinen die von Ihnen bevorzugte URL unter mehreren ähnlichen oder identischen Seiten zu. Die Kernwirkung: Google bündelt Duplicate-Content-Signale auf eine Version und reduziert so Indexierungsprobleme. Die wichtigste Sofortmaßnahme lautet, auf jeder Seite eine selbstreferenzierende, absolute Canonical-URL zu setzen und das Ergebnis danach in der Search Console zu kontrollieren.
Kurz gesagt:
- Eine 301-Weiterleitung ist stärker als ein kanonischer Verweis und eignet sich, wenn eine URL dauerhaft verschwindet; parallel erreichbare Druckversionen können dagegen bestehen bleiben.
- Sitemap, kanonische Angabe und interne Links sollten dieselbe Zieladresse nennen, denn widersprüchliche Signale können Google dazu bringen, eine andere URL auszuwählen.
- Die kanonische Angabe gehört mit absoluter URL in den Kopfbereich; pro Seite verwenden Sie entweder HTML oder den Antwortkopf, nie beides widersprüchlich.
- Bei Sprachversionen muss jede Seite auf sich selbst verweisen; paginierte Seiten behalten meist eigene Angaben, bei PDFs gehört der Verweis in den Antwortkopf der HTTP-Antwort.
- Die URL-Inspektion in der Search Console zeigt Googles tatsächlich gewählte kanonische URL; ein Live-Test auf einer Entwicklungsumgebung kann diese Auswahl nicht zuverlässig vorhersagen.
Inhaltsverzeichnis
- Was ist Kanonisierung und wie funktionieren Canonical-Tags technisch?
- Welche Signale hat Priorität? Die technische Hierarchie der Kanonisierung
- Wann rel=“canonical” einsetzen, wann Redirect oder noindex?
- Praktische Implementierung: HTML, HTTP-Header und strukturierte Daten
- Häufige Fehler und Debugging mit Search Console und Crawl-Logs
- Praxischeckliste: Schritt-für-Schritt-Checks für Release und Monitoring
- Autorensicht: Warum technische Expertise bei Canonical-Tags zählt
- Canonical-Implementierung als Teil unseres Leistungsangebots
- FAQ
- Quellen
Was ist Kanonisierung und wie funktionieren Canonical-Tags technisch?
Kanonisierung ist der Prozess, mit dem Google mehrere ähnliche oder identische URLs zu einem Cluster zusammenfasst und daraus die repräsentativste Version auswählt. Diese eine URL erscheint dann vorrangig in den Suchergebnissen, während die übrigen Varianten im Hintergrund bleiben, aber weiterhin erreichbar sind. Laut Google Search Central stützt sich diese Auswahl auf mehrere Signale gleichzeitig: HTTPS gegenüber HTTP, bestehende Weiterleitungen, Einträge in der Sitemap und eben das rel="canonical"-Attribut.
Wichtig dabei: Ein Canonical-Tag ist ein Hinweis, kein Befehl. Google kann die Vorgabe überschreiben, wenn andere Signale dagegen sprechen oder wenn eine andere Version inhaltlich stärker wirkt. Das unterscheidet rel="canonical" fundamental von einer Weiterleitung, die technisch bindend ist.
Für Betreiber großer oder personalisierter Plattformen, etwa mit Session-IDs oder Tracking-Parametern in der URL, zahlt sich eine konsequente interne Linkpolitik aus, die Sie mit einem SEO- & KI-Check schnell überprüfen können. Interne Links sollten durchgehend auf die kanonische Version zeigen, nicht auf Parametervarianten, denn das verstärkt das Signal zusätzlich zum Tag selbst. Gerade bei Shops mit Filterseiten oder bei Websites mit mehreren Sprachversionen entscheidet diese Konsistenz oft darüber, ob Google die gewünschte URL tatsächlich wählt oder eine andere Variante bevorzugt.
Welche Signale hat Priorität? Die technische Hierarchie der Kanonisierung
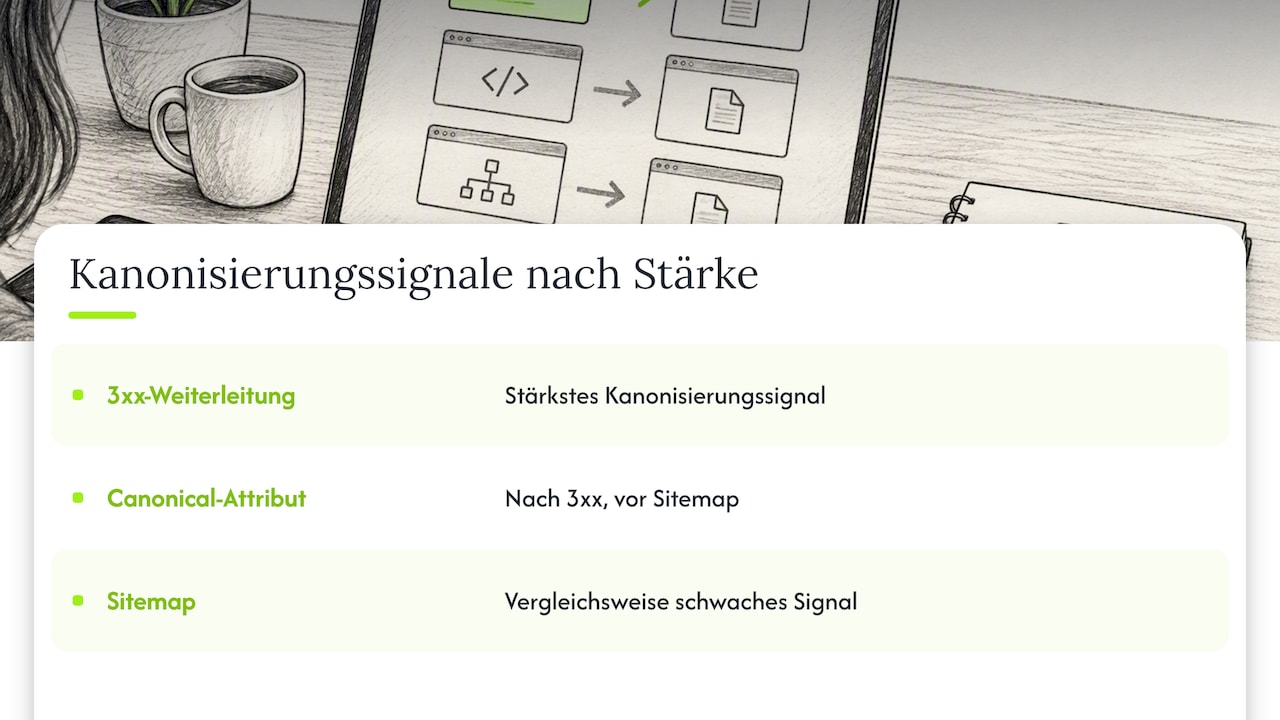
Nicht jedes Signal zählt gleich viel. Laut Google Search Central gilt eine klare Rangfolge: Eine 3xx-Weiterleitung ist das stärkste Kanonisierungssignal, gefolgt vom rel="canonical"-Attribut, während ein Eintrag in der Sitemap vergleichsweise schwach wirkt. Diese Hierarchie hat praktische Konsequenzen für jede technische Entscheidung.
Wer eine Seite endgültig entfernen oder zwei Seiten dauerhaft zusammenführen will, sollte eine Weiterleitung setzen, keinen Canonical-Tag. Wer dagegen zwei Versionen parallel erreichbar halten muss, etwa eine Druckansicht neben der Standardseite, ist mit rel="canonical" besser bedient.
Kombinationen erhöhen die Wahrscheinlichkeit, dass Google die gewünschte URL auswählt, aber nur, wenn sie sich nicht widersprechen. Zeigt die Sitemap auf URL A, während das Canonical-Tag auf URL B verweist, entsteht ein Konflikt, den Google selbst auflösen muss, mit unsicherem Ausgang. Ebenso riskant: Wenn interne Links größtenteils auf eine Nicht-Canonical-Version zeigen, kann das die Auswahl unabhängig vom Tag verschieben.
In der Praxis zeigt sich das häufig bei URL-Parametern für Sortierung oder Tracking. Selbst mit korrektem Canonical-Tag entscheidet sich Google manchmal für eine andere Variante, wenn diese mehr interne Links, bessere Ladezeiten oder umfangreicheren Inhalt aufweist. Das Tag alleine reicht also nicht, es muss im Gesamtbild der Seite stimmig sein.
Wann rel=“canonical” einsetzen, wann Redirect oder noindex?
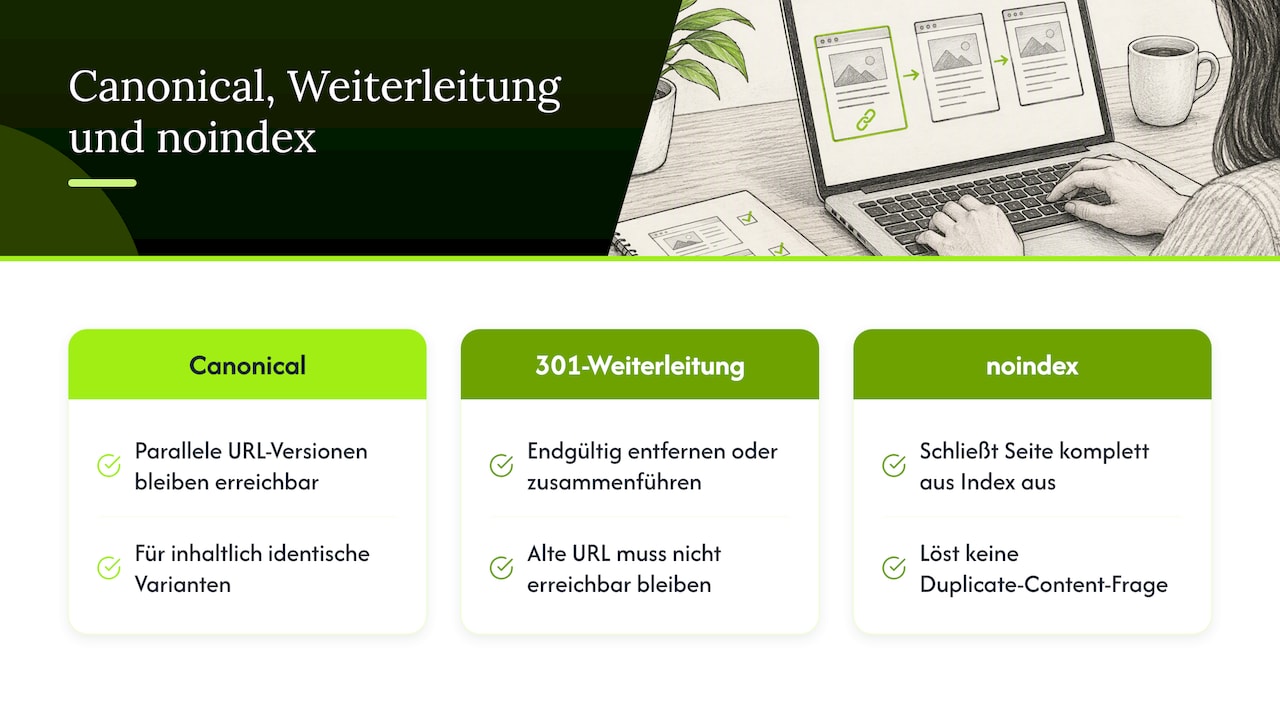
Die Wahl der Methode richtet sich danach, ob eine URL dauerhaft verschwinden soll oder parallel bestehen bleibt. rel="canonical" passt bei URL-Parametern, Druckversionen, Filterkombinationen in Shops oder bei Inhalten, die über mehrere Pfade erreichbar sind, aber inhaltlich identisch bleiben sollen.
Eine 301-Weiterleitung ist die bessere Wahl, wenn eine Seite endgültig entfernt oder mit einer anderen zusammengeführt wird, etwa nach einem Relaunch oder einer Domainmigration. Hier besteht keine Notwendigkeit, die alte URL erreichbar zu halten.
noindex ist kein Ersatz für Kanonisierung. Es verhindert die Indexierung einer Seite komplett, löst aber keine Duplicate-Content-Frage zwischen zwei Versionen. Wird noindex gemeinsam mit einem Canonical-Tag auf dieselbe Seite gesetzt, entsteht ein widersprüchliches Signal, das Google unterschiedlich interpretieren kann.
Bei Sonderfällen gelten eigene Regeln: Paginierte Serien benötigen in der Regel keine Canonical-Verweise auf die erste Seite, da jede Seite eigenen Inhalt trägt. Bei hreflang-Setups muss jede Sprachversion auf sich selbst kanonisieren, nie auf eine andere Sprache. AMP-Seiten verweisen per Canonical auf die reguläre Seite, und PDFs oder andere Nicht-HTML-Dateien benötigen die HTTP-Header-Variante, da sie kein <head>-Element besitzen.
Praktische Implementierung: HTML, HTTP-Header und strukturierte Daten
Das <link rel="canonical">-Element gehört ausschließlich in den <head>-Bereich einer HTML-Seite, niemals in den <body>. Die URL sollte dabei immer absolut angegeben werden, also mit vollständigem Protokoll und Domain, nicht relativ, da relative Pfade bei Weiterleitungen oder CDN-Varianten zu Fehlinterpretationen führen können.
Für Dateien ohne HTML-Struktur, etwa PDFs, bietet sich laut Google Search Central die HTTP-Header-Methode an: Das Canonical-Signal wird dann serverseitig im Response-Header mitgeliefert, nicht im Dokument selbst.
Für die Praxis gilt eine kurze Merkliste:
- Jede Seite trägt einen Self-Canonical auf ihre eigene, absolute URL.
- Strukturierte Daten, idealerweise als JSON-LD, bleiben über alle Varianten konsistent, damit Google Search Central sie korrekt zuordnen kann, selbst wenn eine andere Version gecrawlt wird.
- Nur eine Implementierungsmethode je Seite wählen, HTML-Tag oder HTTP-Header, nie beide widersprüchlich parallel.
- Bei CMS-Systemen die automatisch generierten Canonical-Werte stichprobenhaft prüfen, da Plugins sie gelegentlich falsch setzen.
Gerade bei dynamisch gerenderten oder JavaScript-basierten Seiten lohnt sich ein zusätzlicher Blick auf den serverseitig ausgelieferten Quelltext, denn Canonical-Tags, die erst nach dem Rendering im Browser erscheinen, werden von Crawlern unter Umständen übersehen.
Häufige Fehler und Debugging mit Search Console und Crawl-Logs
Die typischen Fehlerquellen sind erstaunlich konstant und wiederholen sich über Projekte hinweg. Laut dem Google Webmaster Central Blog gehören dazu Canonical-Tags im <body> statt im <head>, relative statt absolute URLs, mehrere widersprüchliche Canonical-Tags auf derselben Seite und Canonicals, die auf eine mit noindex markierte Seite verweisen.
So gehen Sie beim Debugging vor:
- Quelltext der betroffenen Seite im Browser prüfen und das
<link rel="canonical">-Element im<head>suchen. - Server-Header kontrollieren, falls die Canonical-Angabe über HTTP statt im HTML erfolgt.
- CMS- oder Plugin-Einstellungen durchsehen, da automatisierte Systeme laut Google Search Central URL-Parameter gelegentlich falsch verarbeiten.
- Die URL-Inspektion in der Search Console öffnen und die dort angezeigte „von Google ausgewählte kanonische URL“ mit der eigenen Angabe vergleichen.
Laut Search Console Hilfe zeigt das URL-Prüftool genau diese von Google gewählte kanonische URL an, und das ist derzeit der verlässlichste Weg, um die tatsächliche Entscheidung zu sehen. Ein Live-Test auf einem Entwicklungsserver sagt diese Auswahl nicht zuverlässig voraus.
Profi-Tipp: Canonical-Checks gehören als festes Review-Item in jedes Deployment, nicht als nachträgliche SEO-Kontrolle, denn ein einziges fehlerhaftes CMS-Update kann Tausende Seiten betreffen.
Praxischeckliste: Schritt-für-Schritt-Checks für Release und Monitoring
Eine feste Abfolge reduziert das Fehlerrisiko bei jedem Release deutlich:
- Self-Canonical auf jeder Seite setzen, mit absoluter URL.
- Prüfen, dass keine relativen Pfade oder doppelten Tags vorkommen.
- Interne Links auf die kanonische Version ausrichten, nicht auf Parametervarianten.
- Betroffene URLs in der Search Console inspizieren und die Google-Auswahl abgleichen.
Diese Prüfungen lassen sich laut Google Search Central teilweise automatisieren: End-to-End-Tests können vor jedem Deploy kontrollieren, ob das Canonical-Element vorhanden ist, eine absolute URL enthält und nicht im Widerspruch zu einem noindex-Tag steht. Für laufendes Monitoring reicht eine regelmäßige Kontrolle über Crawl-Logs und die Search Console, am besten nach jedem größeren Release und danach in festen Abständen.
Autorensicht: Warum technische Expertise bei Canonical-Tags zählt
Canonical-Fehler entstehen selten durch Unwissen über die Theorie, sondern durch die Lücke zwischen SEO-Wissen und technischer Umsetzung. Ein CMS-Plugin, das bei einem Update stillschweigend falsche Parameter in die Canonical-URL schreibt, bleibt oft monatelang unentdeckt, bis die Indexierung einbricht.
Unser Schwerpunkt liegt genau an dieser Schnittstelle: technisches SEO, Indexierungsfragen und der Umgang mit modernen Web-Frameworks, in denen Rendering und Quelltext oft auseinanderlaufen. Wiederkehrende Probleme, die wir sehen, sind fehlerhafte CMS-Konfigurationen, widersprüchliche Signale zwischen Sitemap und Canonical-Tag sowie JavaScript-Seiten, deren Canonical erst nach dem Rendering sichtbar wird.
— Aliniyaz
Canonical-Implementierung als Teil unseres Leistungsangebots
Eine saubere Canonical-Struktur ist meist nur ein Baustein von mehreren technischen Baustellen. Im Rahmen von Technical SEO prüfen wir Indexierung, Crawling und Canonical-Signale gemeinsam, statt sie isoliert zu betrachten, und priorisieren die Maßnahmen, die tatsächlich Sichtbarkeit bringen.
Für laufende Betreuung bieten wir die monatliche Pauschale SEO Essentials ab 999 € pro Monat an, mit höheren Stufen für größere Projekte. Einen Überblick über alle Preise finden Sie auf unserer Website, oder Sie fragen direkt ein Audit an.
FAQ
Was bedeutet „kanonisch“ im Zusammenhang mit SEO?
„Kanonisch“ bezeichnet die von Google als repräsentativ ausgewählte URL unter mehreren ähnlichen oder identischen Seitenversionen. Diese URL wird laut Google Search Central bevorzugt indexiert und meist in den Suchergebnissen angezeigt, während die übrigen Varianten im Hintergrund bleiben.
Was sind Tags im Kontext von SEO?
SEO-Tags sind HTML-Elemente im Dokumentenkopf, die Suchmaschinen zusätzliche Informationen über eine Seite liefern, etwa Title-Tag, Meta-Description oder das Canonical-Tag. Das Canonical-Tag speziell teilt mit, welche URL unter mehreren ähnlichen Versionen bevorzugt werden soll.
Was ist eine nicht-kanonische URL?
Eine nicht-kanonische URL ist eine von mehreren ähnlichen Seitenversionen, die nicht als die bevorzugte Variante ausgewählt wurde. Sie bleibt technisch erreichbar, wird aber zugunsten der kanonischen URL in den Suchergebnissen meist zurückgestellt.
Was ist ein Beispiel für eine kanonische URL?
Ein typisches Beispiel ist eine Produktseite, die über mehrere URLs mit unterschiedlichen Sortier- oder Tracking-Parametern erreichbar ist, wobei alle Varianten per rel="canonical" auf die parameterfreie Hauptversion verweisen. Diese Hauptversion ist dann die kanonische URL, die Google bevorzugt indexiert.
Wie finde ich heraus, welche URL Google tatsächlich als kanonisch wählt?
Am verlässlichsten zeigt das die URL-Inspektion in der Search Console, die laut Search Console Hilfe die von Google ausgewählte kanonische URL direkt anzeigt. Ein Live-Test auf einer Testumgebung ersetzt diese Prüfung nicht zuverlässig.
Quellen
Empfehlungen
Fragen zu Ihrer eigenen Website?
Besprechen wir unverbindlich, wo Ihre größten SEO-Chancen liegen.