Logfile-Analyse für SEO: So lesen Sie, was Google wirklich crawlt
Logfiles zeigen jeden echten Googlebot-Request mit Timestamp, URL und Statuscode, ganz ohne Stichproben oder Schätzungen. Genau deshalb sind sie die belastbarste Grundlage, um technische SEO-Maßnahmen zu priorisieren: Sie erkennen Crawl-Frequenz, Fehlerquoten und Seiten, die nie abgerufen werden. Bedenken Sie nur eines: IP-Adressen gelten als personenbezogene Daten, die DSGVO gilt also auch hier.
Kurz gesagt:
- Fassen Sie Tageslogs eines repräsentativen Zeitraums zusammen, prüfen Sie einheitliches Format und Zeitzone und entpacken Sie ältere Archive vor der Auswertung.
- Filtern Sie zunächst nach der Crawlerkennung, prüfen Sie verdächtige Zugriffe des Googlebots anschließend per Rückwärtsauflösung und Vorwärtsprüfung, statt einer festen Liste von Netzadressen zu vertrauen.
- Beheben Sie zuerst unnötige Parameteraufrufe und Serverfehler der Klasse 5xx auf umsatzrelevanten Pfaden; prüfen Sie danach fehlende Sitemapadressen, Weiterleitungsketten und interne Verlinkung.
- Behandeln Sie gespeicherte Adressen als personenbezogene Daten, legen Sie Löschfristen fest, dokumentieren Sie die Verarbeitung und anonymisieren Sie sie vor der Weitergabe an externe Dienste.
- Bei Websites mit wenigen Dutzend Seiten lohnt sich die Auswertung selten; große Shops profitieren besonders, wenn Filter unnötige Crawlerabrufe verursachen.
Inhaltsverzeichnis
- Was ist Logfile-Analyse? Definition und Aufbau eines Log-Eintrags
- Logfiles sammeln und vorbereiten: Entpacken, Zusammenführen und DSGVO-Pflichten
- Wie erkennen Sie echte Crawler? User-Agent und Reverse-DNS im Vergleich
- Welche Metriken aus Logs wirklich zählen
- Praxis: Typische Befunde und die Priorisierung von Maßnahmen
- Werkzeuge und Workflows: Shell-Befehle, Parser und Visualisierung
- Wann lohnt sich Logfile-Analyse besonders?
- Logfile-Analyse und technische Priorisierung: Wir setzen sie für Sie um
- FAQ
- Quellen
Was ist Logfile-Analyse? Definition und Aufbau eines Log-Eintrags
Bei der Logfile-Analyse für SEO werten Sie die Protokolldateien Ihres Webservers aus, um nachzuvollziehen, wie Suchmaschinen-Crawler Ihre Website tatsächlich abrufen. Tools wie die Google Search Console liefern aufbereitete Stichproben und Berichte. Logfiles dagegen protokollieren jeden einzelnen Request, den der Server beantwortet hat: auch den, den kein Analytics-Skript je zu sehen bekommt, weil Crawler kein JavaScript-Tracking auslösen.
Ein einzelner Eintrag ist unscheinbar, enthält aber alles Nötige. Ein typisches Beispiel im üblichen Combined-Format sieht so aus:
[IP-Adresse] - - [Zeitstempel] "GET /produkte/schuhe?farbe=rot [HTTP-Version]" [Statuscode] [Bytes] "-" "[User-Agent]"
Daraus lesen Sie ab:
- Timestamp: Wann kam der Request? Aus der Zeitreihe ergibt sich die Crawl-Frequenz pro Tag, Stunde oder URL-Gruppe.
- IP-Adresse: Von wo kam der Zugriff? Sie brauchen sie, um echte Crawler von Fälschungen zu trennen.
- User-Agent: Wer gibt vor, zu fragen? Googlebot, Bingbot oder ein Scraper im Googlebot-Kostüm.
- Methode und URL: Welche Ressource wurde abgerufen, inklusive Parametern?
- Statuscode: verschiedene Statuscodes: das Ergebnis aus Sicht des Servers.
- Bytes und Response-Time: Wie groß war die Antwort, wie lange hat der Server gebraucht? Die Antwortzeit steht nicht im Standardformat, Sie müssen sie meist erst ins Format aufnehmen.
Apache und Nginx schreiben ähnliche Felder, aber in leicht unterschiedlicher Konfiguration. Wie Apache sein Format über Platzhalter festlegt, steht in der Apache-Dokumentation zu mod_log_config. Nginx beschreibt seine Variante im Log-Modul. Beide erlauben eigene Formate. Prüfen Sie deshalb zuerst, welche Felder Ihr Server wirklich schreibt, bevor Sie einen Parser bauen. Und rechnen Sie damit, dass ältere Dateien als .gz-Archive vorliegen, dazu mehr im nächsten Abschnitt.
Logfiles sammeln und vorbereiten: Entpacken, Zusammenführen und DSGVO-Pflichten
Bevor Sie etwas auswerten, brauchen Sie einen repräsentativen Zeitraum. Ein einzelner Tag taugt selten: Crawler arbeiten in Wellen, Releases verschieben das Bild, Wochenenden verzerren es. Als Faustregel gilt: Wählen Sie einen repräsentativen Zeitraum, bei großen Seiten eher einen längeren.
Die meisten Hoster rotieren Logs täglich und komprimieren ältere Dateien. Viele Logdateien liegen deshalb als .gz vor und müssen vor der Analyse entpackt und zu einem Analysezeitraum zusammengeführt werden. So gehen Sie vor:
- Fordern Sie beim Hoster oder in Ihrer Serverumgebung Zugriff auf die Rohlogs an, nicht auf vorgefertigte Statistiken.
- Kopieren Sie die Dateien des gewünschten Zeitraums in ein eigenes Arbeitsverzeichnis, niemals direkt auf dem Produktivserver bearbeiten.
- Entpacken Sie die Archive, etwa mit
gunzip *.gz. - Führen Sie die Tageslogs chronologisch zusammen, zum Beispiel mit
cat access.log-* > analyse.log. - Prüfen Sie stichprobenartig, ob Zeilenformat und Zeitzone über alle Dateien einheitlich sind. Ein Umstellungstag auf ein anderes Logformat ist ein klassischer Stolperstein.
- Entscheiden Sie, ob Sie IP-Adressen vor der Weiterverarbeitung kürzen oder anonymisieren.
Der letzte Punkt ist keine Kür. Wie die Bundesregierung in ihren Datenschutzhinweisen zeigt, fällt die Verarbeitung von Server-Logfiles unter die DSGVO, weil IP-Adressen als personenbezogene Daten gelten. Sie müssen Speicherfristen festlegen und die Verarbeitung in der Datenschutzerklärung dokumentieren. Für Analysezwecke ist die Rechtsgrundlage sorgfältig zu prüfen, häufig trägt das berechtigte Interesse. Übermitteln Sie Daten an externe Tools, ist die Anonymisierung der IP-Adressen vorab für EU-Websites verpflichtend. Die einfachste Lösung: lokal auswerten, dann verlassen die Daten Ihre Umgebung gar nicht erst.
Profi-Tipp: Kürzen oder anonymisieren Sie IPs schon beim Zusammenführen, und behalten Sie vorab eine separate Liste verifizierter Crawler-Zugriffe. So bleibt die Crawler-Prüfung möglich, während die Analysedatei kaum noch Personenbezug trägt.
Planen Sie außerdem Logrotation und Aufbewahrungsfristen bewusst. Wer Rohlogs ohne Löschkonzept sammelt, baut sich ein Compliance-Problem, das mit jedem Tag wächst.
Wie erkennen Sie echte Crawler? User-Agent und Reverse-DNS im Vergleich
Der User-Agent ist ein bloßer Textstring, und jeder Scraper kann „Googlebot/2.1“ hineinschreiben. Wer seine Analyse allein darauf stützt, misst im Zweifel Fremdverkehr und zieht falsche Schlüsse. Google selbst nennt drei Wege zur Identifikation: User-Agent, Quell-IP und Reverse-DNS. Dort finden Sie auch die gängigen Crawler-Strings samt der produktspezifischen Tokens, etwa für Bilder oder Mobilgeräte.
Praktisch läuft die Verifikation so ab:
- Filtern nach User-Agent: Zuerst grenzen Sie alle Zeilen ein, die sich als Googlebot ausgeben, zum Beispiel per
grep "Googlebot" analyse.log. - Reverse-DNS-Lookup: Pro verdächtiger IP fragen Sie den Hostnamen ab (
host [IP-Adresse]). Bei echten Google-Crawlern lässt sich die Identität über Reverse-DNS und eine anschließende Forward-DNS-Gegenprüfung verifizieren. - Gegenprüfung per Forward-DNS: Lösen Sie den erhaltenen Hostnamen wieder in eine IP auf. Nur wenn beide Richtungen übereinstimmen, ist der Zugriff verifiziert.
- Treffer cachen: Bei vielen Zeilen lohnt es sich, jede IP nur einmal zu prüfen und das Ergebnis zu speichern.
Eine Besonderheit sollten Sie kennen: Google betreibt eine global verteilte, dynamische Crawling-Infrastruktur. In Ihren Logs tauchen deshalb viele verschiedene IP-Adressen auf, und eine feste Liste veraltet schnell. Das Reverse-DNS-Verfahren ist robuster als jede statische Liste, wenn auch aufwendiger. Gleiches gilt für andere Suchmaschinen: Bing und Co. dokumentieren ihre eigenen Prüfwege.
Welche Metriken aus Logs wirklich zählen
Wer Logs öffnet, ertrinkt schnell in Zahlen. Entscheidend sind wenige Kennzahlen, die sich direkt in Maßnahmen übersetzen lassen.
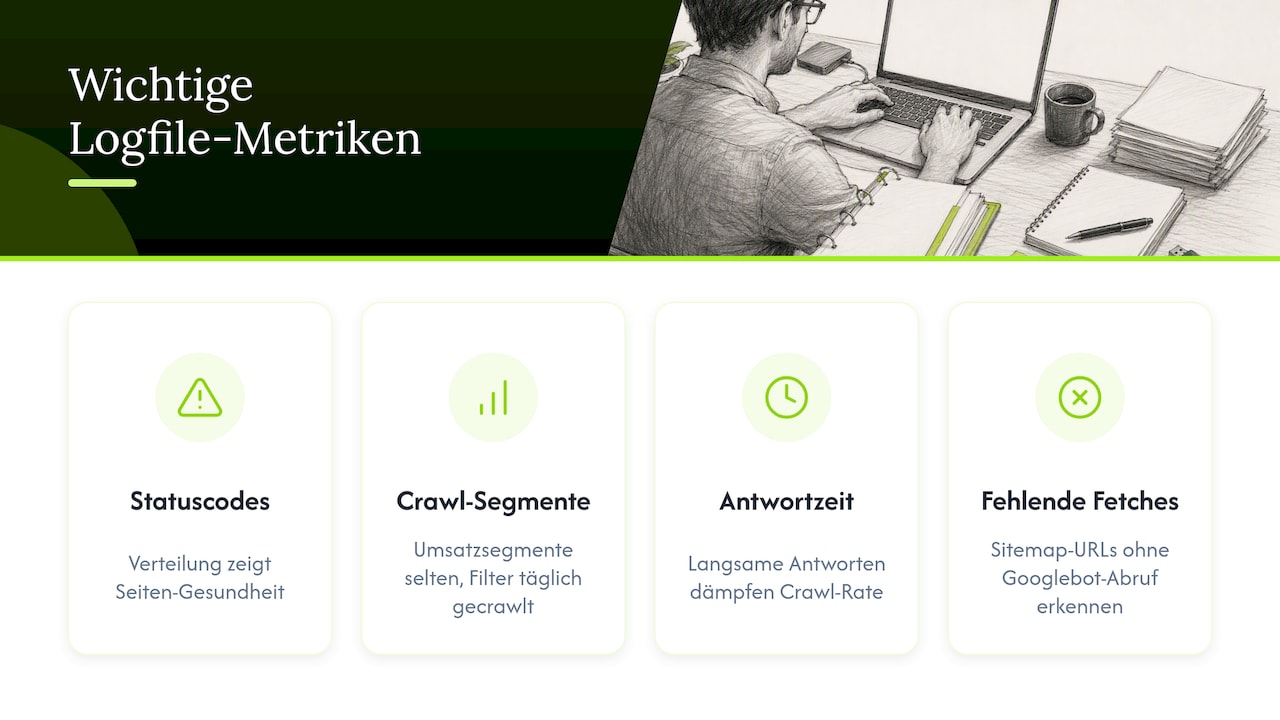
Statuscodes. Die Verteilung über alle Googlebot-Requests verrät den Gesundheitszustand Ihrer Seite. Erfolgreiche Antworten sind gut, aber nur, wenn es die richtigen URLs sind. Weiterleitungsketten verbrauchen Crawl-Kapazität, Fehler auf eigentlich gewollten Seiten kosten Sichtbarkeit, und Serverfehler in wichtigen Pfaden können Google ausbremsen.
Crawl-Frequenz nach Segmenten. Gruppieren Sie URLs nach Verzeichnissen oder Seitentypen: Kategorien, Produkte, Blog, Parameter-URLs, Filter. Dann sehen Sie, wohin das Crawl-Budget tatsächlich fließt. Wird ein umsatzrelevantes Segment kaum besucht, während Filterkombinationen täglich abgegrast werden, ist das ein klares Signal für Verschwendung.
Response-Time und Ressourcen. Langsame Antworten dämpfen die Crawl-Rate. Wenn Googlebot zahlreiche JavaScript- und CSS-Dateien abruft, aber die zugehörige HTML-Seite selten, deutet das auf Rendering-Probleme hin. Mehr dazu in unserem Beitrag zu JavaScript-SEO.
Fehlende Fetchs. Das ist die oft übersehene Metrik. Legen Sie die Liste Ihrer Sitemap-URLs neben die Liste der von Googlebot abgerufenen URLs. Seiten, die in der Sitemap stehen und intern verlinkt sind, aber im Beobachtungszeitraum nie angefragt wurden, haben ein Problem: schwache interne Verlinkung, zu tiefe Klickpfade oder Crawl-Budget, das woanders verpufft. Wie Sie das Crawling gezielt steuern, erklärt die Google-Dokumentation zu Crawling und Indexierung: robots.txt, Meta-Robots und Sitemaps beeinflussen das Crawling, und ein Crawl-Block schließt die Indexierung nicht automatisch aus. Das ist ein Grund mehr, robots.txt-Änderungen immer gegen die Logdaten zu prüfen. Grundlagen dazu finden Sie in unserem Artikel zu robots.txt für SEO.
Die Kernaussage zum Mitnehmen: Google steuert Crawling und Indexierung über robots.txt, Meta-Robots und Sitemaps, und ein Crawl-Block verhindert nicht automatisch die Indexierung. Logfiles sind der einzige Weg, zu überprüfen, ob Ihre Steuerung beim Crawler so ankommt, wie Sie es planen.
Ein Hinweis zur Rechnung: Die Zahlen sind nur im Verhältnis aussagekräftig. Vergleichen Sie Segmente untereinander und Zeiträume miteinander, statt einzelne Absolutwerte zu interpretieren.
Praxis: Typische Befunde und die Priorisierung von Maßnahmen
Aus unserer Arbeit tauchen immer wieder dieselben Muster auf. Besonders häufig: Googlebot verbringt einen großen Teil seiner Zeit auf Parameter-URLs wie Sortierungen, Session-IDs oder Filterkombinationen. Dazu kommen 5xx-Fehler in genau den Pfaden, die Umsatz bringen, und Sitemap-URLs, die nie abgerufen werden. Jeder dieser Befunde ruft nach einer anderen Maßnahme.
Ein bewährter Rahmen ist die Gegenüberstellung von Wirkung und Aufwand:
- Schnelle Fixes (Tage): robots.txt-Regeln für nutzlose Parameter,
noindexauf dünne Filterseiten, defekte interne Links reparieren, 5xx-Ursachen mit dem Hosting klären. - Mittelfristig (Wochen): Canonical-Tags sauber setzen, Redirect-Ketten auflösen, Sitemaps bereinigen, damit dort nur indexierbare 200er stehen.
- Langfristig (Monate): Seitenarchitektur und interne Verlinkung überarbeiten, damit wichtige Seiten flach erreichbar sind; Rendering-Strategie bei JavaScript-lastigen Seiten neu denken.
Das Prinzip dahinter: Zuerst das beheben, was viel Crawl-Kapazität bindet und wenig Aufwand verursacht. Wie wir technische Punkte generell sortieren, zeigt unsere Checkliste zum technischen SEO-Audit.
Für den Schnellcheck nach dem ersten Datenabzug hilft diese kurze Liste:
- Welche URL-Muster erhalten die meisten Googlebot-Requests?
- Wie verteilen sich Weiterleitungen, Clientfehler und Serverfehler?
- Welche Sitemap-URLs wurden im Zeitraum nie angefragt?
- Gibt es Verzeichnisse, die Google intensiv crawlt, obwohl sie
noindexoder gesperrt sind? - Steigen Antwortzeiten zu bestimmten Tageszeiten?
Profi-Tipp: Dokumentieren Sie den Ist-Zustand vor jeder Änderung als Baseline. Nur dann können Sie einige Wochen später im selben Format messen, ob eine robots.txt-Regel oder ein Redirect-Umbau das Crawling wirklich verschoben hat.
Werkzeuge und Workflows: Shell-Befehle, Parser und Visualisierung
Für den Einstieg reichen Bordmittel. Die Kommandozeile erledigt mehr, als man erwartet: Mit gunzip entpacken Sie Archive, mit grep filtern Sie nach Crawler, mit awk zählen Sie Statuscodes oder Pfadsegmente. Ein Einzeiler wie awk '{print $9}' analyse.log | sort | uniq -c | sort -rn liefert die Statuscode-Verteilung in Sekunden. Voraussetzung ist ein sauber zusammengeführtes Log, wie oben beschrieben.
Sobald die Datenmengen wachsen, lohnt ein strukturierter Workflow:
- Parsen: Zerlegen Sie die Zeilen in Felder (Zeit, IP, URL, Status, User-Agent) und laden Sie sie in eine Tabelle oder Datenbank.
- Aggregieren: Gruppieren Sie nach URL-Segment, Statuscode und Crawler-Typ, getrennt nach Desktop- und Mobile-Googlebot.
- Abgleichen: Verknüpfen Sie die Ergebnisse mit Sitemap-Listen, Crawl-Daten und Search-Console-Exporten, damit aus Zahlen Zusammenhänge werden.
- Visualisieren: Zeitreihen pro Segment und Heatmaps der Crawl-Frequenz machen Muster für Entscheider sichtbar, die keine Rohdaten lesen wollen.
Achten Sie bei externen Auswertungsdiensten auf den Datenschutz: Was Ihre Umgebung verlässt, sollte vorher anonymisiert sein, und ein Auftragsverarbeitungsvertrag gehört dazu. Für viele Teams ist die lokale Verarbeitung der unkomplizierteste Weg.
Wann lohnt sich Logfile-Analyse besonders?
Bei kleinen Seiten mit wenigen Dutzend URLs bringt sie selten viel. Bei großen Seiten, facettierten Shops und JavaScript-gerenderten Auftritten dagegen entscheidet sie oft, ob Crawl-Budget in Umsatzseiten oder in Filterkombinationen fließt. Prüfen Sie vorab Ihre Indexierungsrate in der Search Console und ob der Traffic plötzlich eingebrochen ist. Erst wenn diese Signale auffällig sind, lohnt der Aufwand. Mein Rat: Starten Sie selbst, solange Sie Daten sauber ziehen und lesen können. Sobald Befunde widersprüchlich werden oder Entwickler Ressourcen binden müssen, sparen ein Audit oder ein Workshop Wochen an Umwegen.
— Aliniyaz
Logfile-Analyse und technische Priorisierung: Wir setzen sie für Sie um
Sie haben Logdaten, aber keine Zeit oder keinen Plan, daraus Maßnahmen abzuleiten? Dann übernehmen wir den Teil, der Erfahrung braucht: Daten validieren, Befunde einordnen, Prioritäten setzen und die Umsetzung begleiten. Das passt bei uns zusammen:
- Technical SEO für Crawling, Indexierung und Performance
- SEO-Audit für technische Analysen und priorisierte Maßnahmen
- Monatliche SEO-Optimierung für die laufende Umsetzung
- Workshops, wenn Ihr Team das Know-how selbst aufbauen soll
Ein erstes Audit hilft dabei, Befunde einzuordnen und Prioritäten zu setzen. Unsere Pakete und Preise finden Sie auf der Preisseite: SEO Foundation startet bei 999 € einmalig, SEO Essentials bei 999 € pro Monat. Fragen Sie jetzt ein Audit an, wir melden uns mit einem konkreten Vorschlag.
Dieser Artikel enthält allgemeine Informationen und ersetzt nicht die Beratung durch einen qualifizierten Anwalt. Wenden Sie sich an eine qualifizierte Rechtsfachperson zu Ihrer persönlichen Lage, bevor Sie auf Grundlage dieses Inhalts handeln.
FAQ
Gibt es ein kostenloses SEO-Analysetool?
Ja, die Google Search Console ist kostenlos und zeigt Indexierung, Suchanfragen und Crawling-Statistiken. Für die Logfile-Analyse selbst reichen Kommandozeilenwerkzeuge wie grep und awk. Beides ersetzt keine vollständige Auswertung, liefert aber einen soliden Einstieg.
Was bedeutet SEO-Analyse?
Eine SEO-Analyse prüft, wie gut eine Website technisch, inhaltlich und strukturell für Suchmaschinen aufgestellt ist. Die Logfile-Analyse ergänzt sie um echte Crawler-Daten: Sie zeigt, was Googlebot tatsächlich abruft, nicht nur, was theoretisch möglich wäre. Daraus entsteht eine priorisierte Maßnahmenliste.
Welcher SEO-Score ist gut?
Einen allgemeingültigen Wert gibt es nicht, denn Scores verschiedener Tools sind nicht vergleichbar und kein Ranking-Faktor. Aussagekräftiger sind konkrete Kennzahlen wie Indexierungsrate, Fehlerquote bei Statuscodes und die Verteilung des Crawl-Budgets in Ihren Logs.
Ist SEO noch sinnvoll?
Ja, solange Menschen Suchmaschinen nutzen, um Angebote zu finden. Technische Grundlagen wie sauberes Crawling und Indexierung bleiben dabei die Voraussetzung dafür, dass Inhalte überhaupt sichtbar werden. Die Logfile-Analyse zeigt, ob diese Voraussetzung bei Ihnen erfüllt ist.
Muss ich IP-Adressen in Logfiles anonymisieren?
IP-Adressen sind nach Hinweisen der Bundesregierung personenbezogene Daten, ihre Verarbeitung muss in der Datenschutzerklärung dokumentiert werden. Bei Weitergabe an externe Tools ist eine Anonymisierung nötig, lokale Verarbeitung vermeidet das Problem weitgehend.
Quellen
Alle technischen Aussagen in diesem Beitrag stützen sich auf Primärquellen: die Dokumentation von Google zu Crawlern und zur Indexierung, die Server-Dokumentation von Apache und Nginx sowie die Datenschutzhinweise der Bundesregierung zur DSGVO. Wo das Gesetz oder Googles Verhalten ins Spiel kommt, verlinken wir die Originalseite, damit Sie selbst nachprüfen können.
Technical SEO und datenbasierte Priorisierung sind unser Tagesgeschäft. Wir verbinden technisches SEO-Wissen mit Erfahrung in modernen Webtechnologien wie React und Next.js und arbeiten mit klar priorisierten Maßnahmen statt mit generischen To-do-Listen. Was Sie von einer sauberen Logfile-Analyse erwarten können: validierte Metriken, eine begründete Reihenfolge der Maßnahmen und KPIs, an denen sich der Erfolg messen lässt. Ranking-Garantien geben wir nicht, dafür nachvollziehbare Daten.
- Bundesregierung
- Stackoverflow
- Google’s common crawlers | Google Crawling Infrastructure | Crawling infrastructure | Google for Developers
Empfehlungen
Fragen zu Ihrer eigenen Website?
Besprechen wir unverbindlich, wo Ihre größten SEO-Chancen liegen.